NGÀNH CNTT TUYỂN SINH NHIỀU CHỈ TIÊU NGÀNH CNTT, CNTT VIỆT NHẬT VÀ KHOA HỌC DỮ LIỆU

Góc học tập

Phát hiện thư rác tiếng Việt sử dụng các mô hình học sâu

on .

Phát hiện thư rác tiếng Việt sử dụng các mô hình học sâu

210201001 - Ngô Thanh Bình

Ra đời từ những ngày đầu của mạng máy tính, trải qua nhiều nâng cấp và cải tiến, thư điện tử ngày nay vẫn là một phương thức trao đổi thông tin chính thức được sử dụng rộng rãi bởi các cá nhân và tổ chức trên toàn thế giới. Bên cạnh những lợi ích to lớn mà thư điện tử mang lại, thư điện tử cũng bị lạm dụng và sử dụng như một công cụ phục vụ cho các mục đích khác nhau trên môi trường mạng máy tính như gửi thư lừa đảo, thư nặc danh, thư quảng cáo, thư xin tài trợ. Những thư này người nhận không mong muốn nhận nên được gọi là thư rác hay SPAM. Để phân biệt với thư rác, thuật ngữ HAM được sử dụng để chỉ thư mà người nhận mong muốn nhận hay không phải thư rác. Thư rác thường gây cảm giác khó chịu khi người sử dụng nhận được chúng hoặc thậm chí gây ra những tổn hại nhất định cả về vật chất và tinh thần nếu người sử dụng trở thành mục tiêu của những kẻ lừa đảo. Chính vì vậy, nhiều giải pháp đã được phát triển để phát hiện thư rác hiệu quả hơn. Trong đó, các mô hình học máy cũng như các mô hình học sâu đã được ứng dụng để phát hiện thư rác và đạt được độ chính xác cao. Tuy nhiên, các mô hình này phần lớn đều được huấn luyện trên bộ dữ liệu tiếng Anh nên chỉ có khả năng phát hiện được thư rác tiếng Anh, chưa có bộ dữ liệu thư rác tiếng Việt để huấn luyện mô hình phát hiện thư rác tiếng Việt. Luận văn này trình bày việc xây dựng bộ dữ liệu thư rác tiếng Việt và ứng dụng các mô hình học sâu gồm CNN, BiLSTM và PhoBert để huấn luyện mô hình phát hiện thư rác tiếng Việt. Kết quả so sánh cho thấy, các mô hình học sâu này đều cho kết quả phát hiện thư rác tiếng Việt với độ chính xác cao. Kết quả huấn luyện cho thấy độ chính xác của các mô hình lần lượt là CNN 88.42%, BiLSTM 83.03% và PhoBert 86.47%.

Việc ứng dụng các mô hình học sâu trong phát hiện thư rác tiếng Việt giúp ngăn chặn thư rác hiệu quả hơn, giải quyết thêm các vấn đề còn tồn đọng như: thích ứng với các chiến thuật gửi thư rác mới hiệu quả hơn thông qua việc huấn luyện và cập nhật mô hình, có thể cá nhân hóa cho các người dùng khác nhau và có thể kết hợp với các hệ thống an ninh khác như hệ thống phát hiện mã độc, hệ thống phát hiện tấn công. Trong tương lai, hệ thống sẽ tiếp tục được cải tiến để ứng dụng trong các hệ thống phát hiện thư rác tiếng Việt.

Trân trọng.
Phát hiện các gian lận kế toán bằng phương pháp máy học tổng hợp

on .

Phát hiện các gian lận kế toán bằng phương pháp máy học tổng hợp

CH2002011 - Huỳnh Thị Tố Ngọc

Báo cáo tài chính (viết tắt là BCTC) là công cụ giúp các nhà đầu tư và những đơn vị liên quan hiểu rõ tài chính của các tổ chức. Trong thời đại ngày nay, tốc độ phát triển của khoa học công nghệ nhanh như vũ bão thì quy mô kinh doanh ngày càng tăng, nguy cơ về gian lận kế toán (GLKT) đã trở thành một thách thức cực kỳ lớn đối với doanh nghiệp và hệ thống tài chính toàn cầu. GLKT không còn đơn thuần là một vấn đề riêng của các doanh nghiệp, mà còn mang theo những hậu quả lớn đối với tính công bằng và minh bạch trong quản lý tài chính. Việc GLKT ngày càng trở nên tinh vi làm cho việc phát hiện và ngăn chặn gian lận trở nên cực kỳ khó khăn.

Trong luận văn này, chúng tôi đã tiến hành trích xuất đặc trưng từ các giá trị dữ liệu thô trong các BCTC và áp dụng phương pháp máy học tổng hợp với thuật toán RUSBoost, AdaBoost, Bagging, phương pháp máy học hồi quy Logistic và SVM để xây dựng mô hình phân loại các GLKT.

Chúng tôi đã tập trung giải quyết hai vấn đề chính. Thứ nhất, đã đóng góp về mặt tập dữ liệu, bổ sung tập dữ liệu cho nghiên cứu khoa học về GLKT từ các BCTC. Thứ hai, qua kết quả số liệu của mô hình thực nghiệm và phân tích số liệu cho thấy kết quả của mô hình máy học tổng hợp tốt hơn so với các mô hình riêng biệt.

Với những kết quả đạt được, đề tài đã phát hiện GLKT trong BCTC và nâng cao độ tin cậy của những BCTC dành cho người sử dụng. Sau khi xây dựng thành công mô hình phát hiện GLKT bằng thuật toán máy học tổng hợp, chúng tôi đề xuất giải pháp tự động hóa quy trình phát hiện GLKT, giảm thiểu sự phụ thuộc vào sự can thiệp của con người. Mục tiêu là tối ưu hóa hiệu suất thời gian, nâng cao độ chính xác, giảm thiểu sai sót do yếu tố con người trong quá trình giám sát, đảm bảo được tính công bằng, minh bạch trong quản lý tài chính và góp phần xây dựng sự ổn định của thị trường kinh doanh và xã hội.

Trân trọng.

Phát hiện xâm nhập sử dụng XGBoost để lựa chọn tính năng với Logarithmic Autoencoder và Bidirectional LSTM

on .

Phát hiện xâm nhập sử dụng XGBoost để lựa chọn tính năng với Logarithmic Autoencoder và Bidirectional LSTM

CH1902033 - Nguyễn Trọng Minh Hồng Phước

Trong bối cảnh hiện nay, với sự bùng nổ của Công nghệ thông tin (CNTT) và các phụ trợ, cuộc sống của chúng ta đang diễn ra một giai đoạn biến đổi mạnh mẽ. Việc phát triển không ngừng này của các ngành trong CNTT này đã đặt ra một thách thức lớn, là làm thế nào để có thể duy trì sự cạnh tranh và thích ứng. Trong bối cảnh này, việc số hóa dữ liệu đang trở thành một vấn đề được đặt ưu tiên lên hàng đầu. Và đồng thời từ việc này cũng đang mở ra những cánh cửa lớn cho những kẻ tấn công tinh vi. Các kẻ tấn công và tên trộm thông tin ngày càng tinh nhuệ hơn, luôn tìm cách xâm nhập trái phép vào các hệ thống dùng để lưu trữ dữ liệu. Đáng nói là các kỹ thuật tấn công vào các hệ thống ngày ngày đang trở nên đa dạng và khó bị phát hiện. Những hệ thống nhận diện truyền thống dựa trên các quy tắc cố định đang dần trở nên yếu thế và thậm chí lạc hậu khi đối mặt với sự tinh vi của các loại tấn công hiện đại.


Với ý tưởng là sẽ kết hợp ưu điểm của hai nhóm phương pháp trong bài toán IDS: Nhóm phương pháp dựa trên máy học và Nhóm phương pháp dựa trên học sâu, đề tài chọn việc kết hợp chúng để tạo ra mẫu đặc trưng của dữ liệu hoạt động mạng có độ phân biệt cao như sau: Mẫu đặc trưng với độ phân biệt cao, được chọn lọc và đóng góp vào việc phân biệt các cuộc tấn công mạng và trạng thái bình thường, ít chịu ảnh hưởng của nhiễu. Học từ đặc trưng dựa vào các kỹ thuật DL cho phép học đặc trưng quan trọng từ dữ liệu mạng. Thực nghiệm được tôi thực hiện sử dụng CSDL của Đại học New Brunswick, Canada (NSL-KDD) cho thấy rằng phương pháp đề xuất vượt trội hơn các phương pháp hiện có đã được công bố.

Trân trọng.

ỨNG DỤNG CÔNG NGHỆ GIS VÀ VIỄN THÁM XÂY DỰNG BẢN ĐỒ TIỀM NĂNG LŨ QUÉT TỈNH QUẢNG TRỊ

on .

ỨNG DỤNG CÔNG NGHỆ GIS VÀ VIỄN THÁM XÂY DỰNG BẢN ĐỒ TIỀM NĂNG LŨ QUÉT TỈNH QUẢNG TRỊ

Trần Võ Tấn Tài, Lê Thị Thiệp, Nguyễn Thị Phương Quyên

Những năm gần đây, nhiều cơn bão, lũ lụt, các trận lũ quét cuốn trôi nhà cửa, tài sản, làm nhiều người thiệt mạng và gián đoạn hoạt động sản xuất, nhất là ở các tỉnh miền trung nước ta. Lũ quét được hình thành do tổng hợp nhiều nhân tố gây nên như: đặc điểm địa hình, kết cấu đất, lớp phủ thực vật, lượng mưa,... Diện tích rừng đầu nguồn bị suy giảm và biến đổi khí hậu làm cho lũ quét xảy ra thường xuyên và khó dự báo hơn. Vì vậy, công tác dự báo, phòng chống lũ quét đóng vai trò quan trọng trong việc giảm thiểu thiệt hại.

Hiện nay hệ thống thông tin địa lý và viễn thám được sử dụng rộng rãi trong nhiều lĩnh vực trong đó có cảnh báo thiên tai. Mục đích của việc nghiên cứu là kết hợp công nghệ viễn thám và GIS với chỉ số tiềm năng lũ quét (FFPI) phân vùng nguy cơ lũ quét tỉnh Quảng Trị.

Tỉnh Quảng Trị thuộc vùng Bắc Trung Bộ. Địa hình núi cao thấp dần từ Tây sang Đông; mưa tập trung theo mùa; mật độ sông suối dày đặc, độ dốc lớn; ngoài ra, diện tích rừng bị suy giảm ở một số khu vực do các hoạt động sinh hoạt động sinh hoạt của con người (khai thác gỗ, mở rộng nông nghiệp,...). Với các đặc điểm tự nhiên trên làm cho Quảng Trị là nơi dễ xảy ra lũ quét. Hơn nữa, kinh tế - xã hội tỉnh Quảng Trị đã có bước phát triển rất rõ rệt, tuy nhiên nền kinh tế còn phụ thuộc nhiều vào nông nghiệp, đời sống vẫn còn nhiều khó khăn. Vì vậy, những tác động từ lũ quét ảnh hưởng nặng nề đến đời sống người dân ở nhiều khía cạnh (tính mạng, tài sản, tinh thần,...).

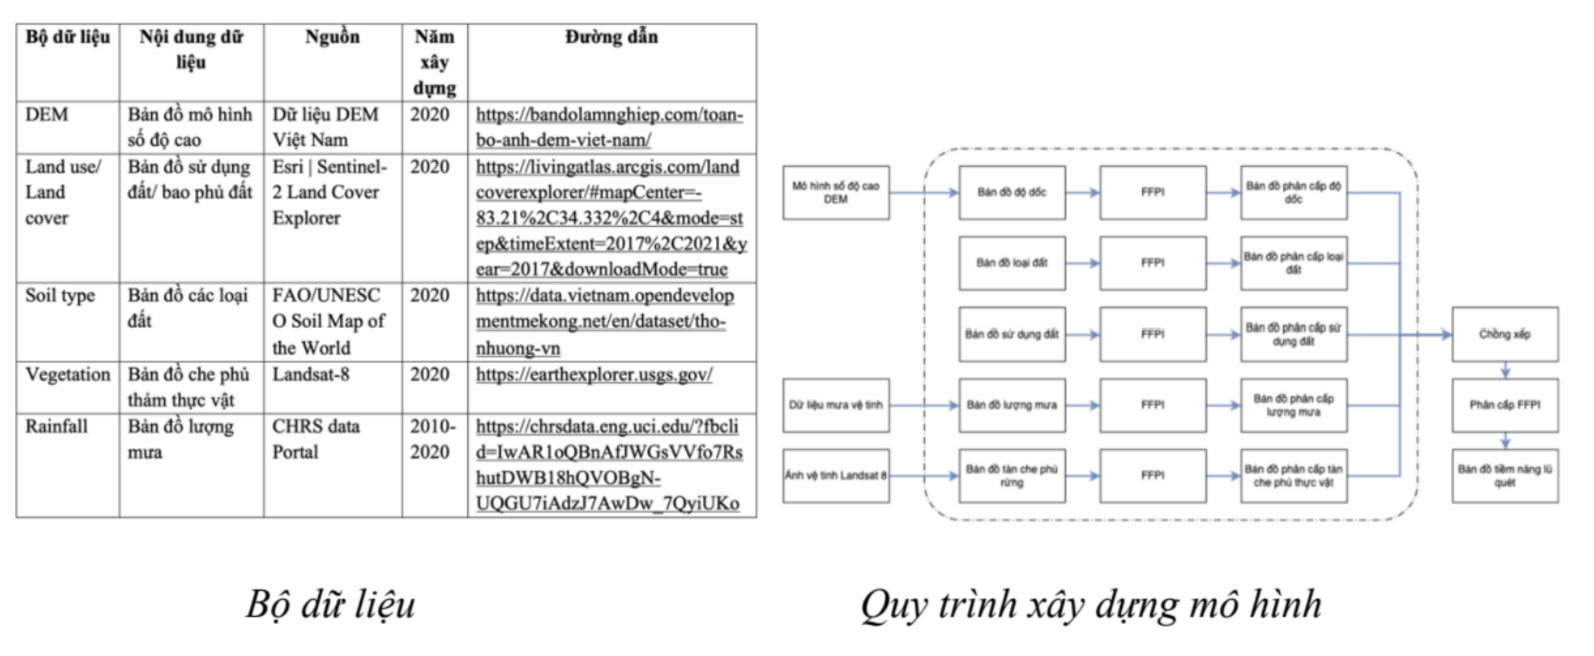
Nội dung của nghiên cứu gồm: Để xây dựng bản đồ tiềm năng lũ quét tỉnh Quảng Trị tiến hành thu thập các dữ liệu và sử dụng phương pháp GIS và viễn thám để xử lí ảnh vệ tinh và phân cấp FFPI (Greg Smith, 2010) cho từng nhân tố thành phần: độ dốc, loại đất, hiện trạng sử dụng đất, độ tàn che rừng, lượng mưa phân bổ. Mỗi lớp dữ liệu sẽ được gán giá trị FFPI từ 1 đến 10, giá trị nhỏ nhất là 1, giá trị lớn nhất là 10. Mỗi thành phần được gắn vào mô hình có trọng số và chồng xếp để ra được bản đồ tiềm năng lũ quét. Giá trị nhỏ nhất là 1 tương ứng với khu vực ít chịu ảnh hưởng nhất và giá trị lớn nhất là 10 tương ứng với khu vực có tiềm năng xảy ra lũ quét cao nhất.


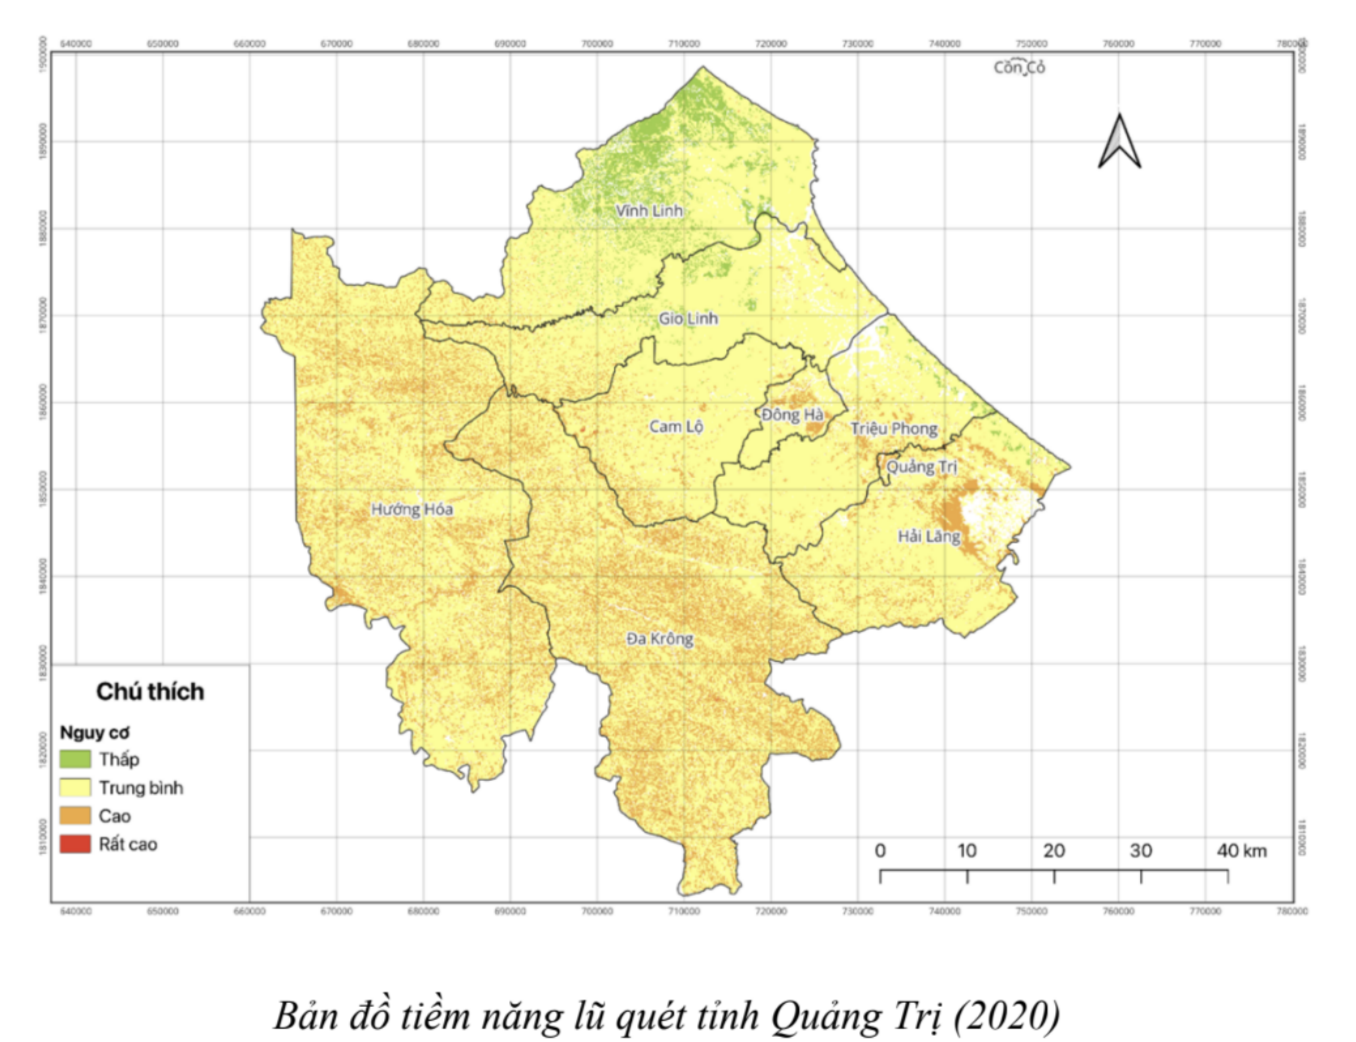
Bản đồ tiềm năng nguy cơ lũ quét tỉnh Quảng Trị được thành lập với 4 mức độ nguy cơ: rất cao, cao, trung bình, thấp. Kết quả phân vùng nguy cơ lũ quét trong tỉnh cho thấy trong 7 huyện và 2 thị xã, trong đó vùng có nguy cơ lũ quét cao hầu hết tại các huyện Đa Krông, Cam Lộ, Hướng Hoá, Hải Lăng. Tổng diện tích của các huyện nằm trong vùng lũ quét rất cao và cao chiếm hơn 20% tổng điện tích toàn tỉnh, đây là những huyện có địa hình núi cao, dốc lớn, phân cắt mạnh, điều kiện đi lại hết sức khó khăn và rất dễ bị cô lập, có nền thổ nhưỡng dạng đất xám nhưng chứa nhiều đất sét khó thấm nước, tán rừng thưa, lượng mưa trung bình tháng khá lớn. Cụ thề: Các huyện phía Tây Đa Krông (383,5 km2), Cam Lộ (30,1 km2), Hướng Hoá (259,8 km2) và vùng ven biển phía Đông Nam Hải Lăng (383,5 km2). Đối với các khu vực có nguy cơ thấp như là Vĩnh Linh, Gio Linh, phía Đông Bắc Cam Lộ, Triệu Phong, Quảng Trị.

Hiện tại, bản đồ đã cung cấp một đánh giá tương đối về các khu vực có nguy cơ xảy ra lũ quét. Tuy nhiên, độ chính xác của nó vẫn còn hạn chế do phụ thuộc chủ yếu vào dữ liệu có sẵn vì không có khả năng đo đạt thông tin thực tế. Nhưng vẫn cho cái nhìn tổng quát về các khu vực có thể xảy ra lũ quét trong tương lai nhằm thực hiện các biện pháp phòng chống và giảm nhẹ thiên tai, góp phần ổn định cuộc sống của cộng đồng.

Trân trọng.

Tích Hợp Phương Trình Mất Đất Phổ Dụng Cải Tiến Rusle Và Hệ Thống Thông Tin Địa Lí GIS Để Ước Tính Xói Mòn Đất Tại Tỉnh Daklak

on .

Tích Hợp Phương Trình Mất Đất Phổ Dụng Cải Tiến Rusle Và Hệ Thống Thông Tin Địa Lí GIS Để Ước Tính Xói Mòn Đất Tại Tỉnh Daklak

Lê Hoàng Phúc (20521762) - Đỗ Hữu Khánh Hưng (20521361) - Nguyễn Trần Lĩnh Đạt (20521173)

Xói mòn đất là một vấn đề nghiêm trọng ở tỉnh Đắk Lắk, Việt Nam. Để đánh giá mức độ xói mòn đất, chúng tôi đã tích hợp mô hình Revised Universal Soil Loss Equation (RUSLE) và hệ thống thông tin địa lý (GIS). Đắk Lắk là vùng tương đối phức tạp về mặt địa hình từ núi cao đến các cao nguyên, thung lũng. Rõ ràng, với đặc tính như vậy, việc áp dụng RUSLE cho vùng cần đặc biệt quan tâm tới hệ số LS và hệ số R vì sự phân bố độ cao địa hình phức tạp và lượng mưa theo mùa lớn dẫn đến tác động vô cùng lớn đến việc xảy ra xói mòn đất. Các hệ số khác như: K, R cũng có những đặc điểm mang tính địa phương rõ nét nếu so sánh với điều kiện nghiên cứu của phương trình RUSLE gốc. Vì thế, để có thể sử dụng công thức RUSLE, nghiên cứu áp dụng công thức của các tác giả Việt Nam đã công bố với các khu vực có điều kiện tương tự để tính toán hệ số R. Thiết lập cơ sở dữ liệu trong GIS:Với cách tiệm cận hệ thống theo từng thông số ảnh hưởng xói mòn. Để có thể tính toán xói mòn trên GIS, việc đầu tiên là xây dựng cơ sở dữ liệu. Các thông số của mô hình (các hệ số R, LS, K) được tính toán từ các dữ liệu đầu vào (các bản đồ). Trong nghiên cứu này mục tiêu đặt ra là tính toán, xây dựng bản đồ xói mòn đất tiềm năng, vậy chúng tôi cần phải tính toán các hệ số: R, LS, K. Từ đó dựa trên bản đồ hệ số R, bản đồ hệ số LS, bản đồ hệ số K để thành lập bản đồ xói mòn tiềm năng Đắk Lắk.

rusle

Kết quả nghiên cứu cho thấy rằng có sự biến động về mức độ xói mòn trên khắp địa bàn tỉnh, và những vùng có mức độ mất mát đất cao nhất chủ yếu tập trung ở phía Bắc và Đông Nam của tỉnh. Cụ thể, những khu vực có mức độ xói mòn đất cao nhất được xác định là ở phía Nam, đặc biệt là khu vực núi Chu Yang Sin và núi Chu Mu. Ngoài ra, ở phía Bắc, huyện Ea H'Leo cũng là một trong những khu vực nổi bật với mức độ mất mát đất do xói mòn đáng kể với lượng xói mòn có những nơi lên đến hơn 39.5 tấn/ha/năm.

rusle_result

Nghiên cứu cũng chỉ ra rằng các khu vực có địa hình tương đối bằng phẳng hoặc thấp trũng, kết hợp với lượng mưa phân tán trong mùa mưa, chiếm phần lớn diện tích tự nhiên của Tây Nguyên và không bị xói mòn nhiều, chiếm 77,34% tổng diện tích. Trong khi đó, địa hình đồi 11 núi, đặc biệt là khu vực có khả năng kháng xói mòn thấp, chiếm khoảng 18,47% diện tích tự nhiên, phần lớn nằm trên đồi, núi thấp hay rìa các cao nguyên. Các khu vực này có tiềm năng xói mòn trung bình chiếm khoảng 2,78% diện tích tự nhiên. Có thể thấy rằng ảnh hưởng của địa hình và mức độ mưa đối với xói mòn là lớn, đồng thời cần chú ý đến việc quản lý và bảo vệ đất ở những khu vực có tiềm năng xói mòn mạnh như đã phân tích. Những thông tin này sẽ là cơ sở để các quyết định trong quá trình qui hoạch sử dụng đất vùng miền núi, giúp giảm thiểu nguy cơ xói mòn và bảo vệ nguồn đất hiệu quả.

Nghiên cứu cũng nhấn mạnh về tầm quan trọng của việc đo lường và quản lý xói mòn để bảo vệ tài nguyên đất và nước. Trong bối cảnh thay đổi sử dụng đất trở thành vấn đề quan trọng ở Việt Nam, đặc biệt là ở các khu vực đồi núi, nghiên cứu này cung cấp thông tin lịch sử và dự báo xu hướng sử dụng đất tại Đắk Lắk trong 20 năm qua. Điều này giúp những người quản lý chính sách địa phương đưa ra quyết định đúng đắn, kết hợp phát triển kinh tế, xã hội và bảo vệ môi trường. Sử dụng mô hình RUSLE cải tiến và GIS, nghiên cứu này cung cấp công cụ hiệu quả để đánh giá xói mòn tiềm năng tại Đắk Lắk, đồng thời hỗ trợ quyết định chính sách và quản lý môi trường tại cấp địa phương.

Trân trọng.